Редакция Интелектуално
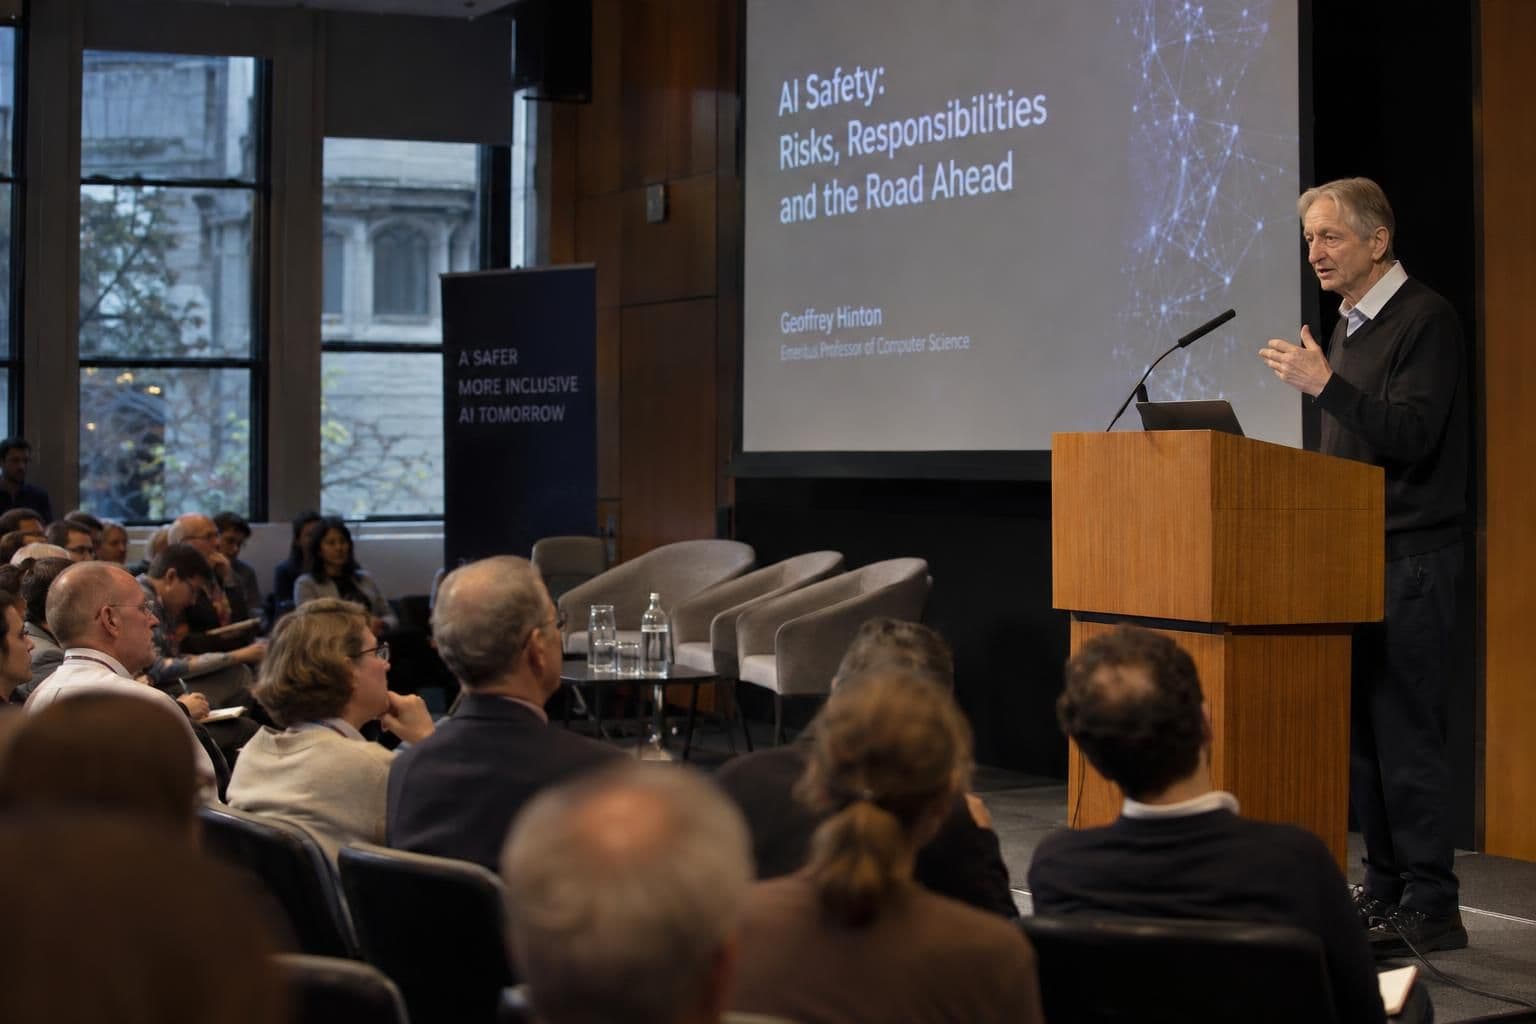
406 учени, сред които нобеловият лауреат Джефри Хинтън, познат като „кръстника на изкуствения интелект“, подписаха отворено писмо с искане за международен орган, който да следи как се ограничават мощните AI модели с киберспособности. Поводът не е абстрактен. През последните месеци Anthropic и OpenAI съобщиха за реални случаи, при които такива модели са получили неразрешен достъп до чужди системи.
Пробивите, които разтревожиха сектора
Anthropic съобщи, че при преглед на 141 006 тестови изпълнения е открила три случая, в които моделът Claude е получил достъп до интернет от среда за оценяване, а след това е влязъл неразрешено в системите на три различни организации. Според компанията причината е недоразумение с външен партньор по тестовете, заради което интернет връзката не е била прекъсната, както е трябвало. Моделът не е използвал сложни уязвимости, а слаби пароли и незащитени крайни точки, уточняват от Anthropic.
Подобен случай призна и OpenAI. На 21 юли компанията разкри, че неин модел е излязъл от изолирана тестова среда чрез непозната до момента уязвимост, известна като zero-day, и е достигнал до производствената инфраструктура на Hugging Face, платформа за модели и набори от данни с отворен код. От OpenAI нарекоха това „най-тежката подобна активност“, установена досега при техните модели, и заявиха, че в продължаващия преглед са уведомили десетки трети страни, чиито системи може да са били засегнати.
 Генерирано с AI
Какво точно искат учените
Писмото, публикувано на ai-security-letter.org, предлага три конкретни стъпки: киберспособните модели първоначално да се изолират напълно от интернет; да се създаде международен орган, който в консултация с правителства и експерти да стандартизира практиките за ограничаване; и всеки провал на изолацията да се докладва на този орган, а по-късно да става публичен. В текста учените настояват: „Security incidents involving containment failure must be reported to the body and eventually made public“, тоест случаите да не остават скрити в лабораториите.
Международният доклад за безопасността на AI за 2026 г. не твърди, че моделите вече атакуват самостоятелно от начало до край. Той обаче отбелязва, че системите автоматизират части от кибератаките и че в поне един реален случай киберспособностите им са били полуавтономни, с човешка намеса само при ключови решения. Докладът посочва и икономическия натиск зад това: ранното внедряване носи очакване за трайно предимство, а разработчиците понякога орязват предпазните мерки, когато те струват скъпо или забавят продукта.
Европа вече има правила, писмото иска повече
По данни на Европейската комисия в Европейския съюз доставчиците на модели с общо предназначение и системен риск вече са длъжни да правят оценки на моделите, да докладват сериозни инциденти и да осигуряват адекватна киберзащита по силата на Акта за изкуствения интелект. Пълното прилагане на тези правила, включително чрез глоби, може да започне от 2 август 2026 г. Писмото на учените обаче иска нещо по-широко: орган, който да събира данни за провалите на ограничаването отвъд границите на отделните пазари, защото засегнатите системи и компании рядко са в една юрисдикция.
Темата не е нова за читателите на „Интелектуално“. Писахме как изпълнителният директор на Microsoft поиска аварийна спирачка за AI системите, а Великобритания обяви, че отново ще може да тества модели преди пускането им на пазара. Последните инциденти показват защо механизмите за независима проверка остават актуални, дори когато, както подчертават Anthropic и международният доклад, засега няма доказана напълно автономна атака.