Редакция Интелектуално
Кой от трите най-използвани AI асистента върши по-добра работа с данни, статистика и код? Авторски тест на сайта KDnuggets сравнява ChatGPT, Claude и Gemini при реални задачи от работата на анализатор на данни и стига до извод, който едва ли ще се хареса на търсещите еднозначен победител: всеки от трите има различни силни страни и изборът зависи от конкретната задача, а не от обща класация.
Как всеки от трите подхожда към анализа
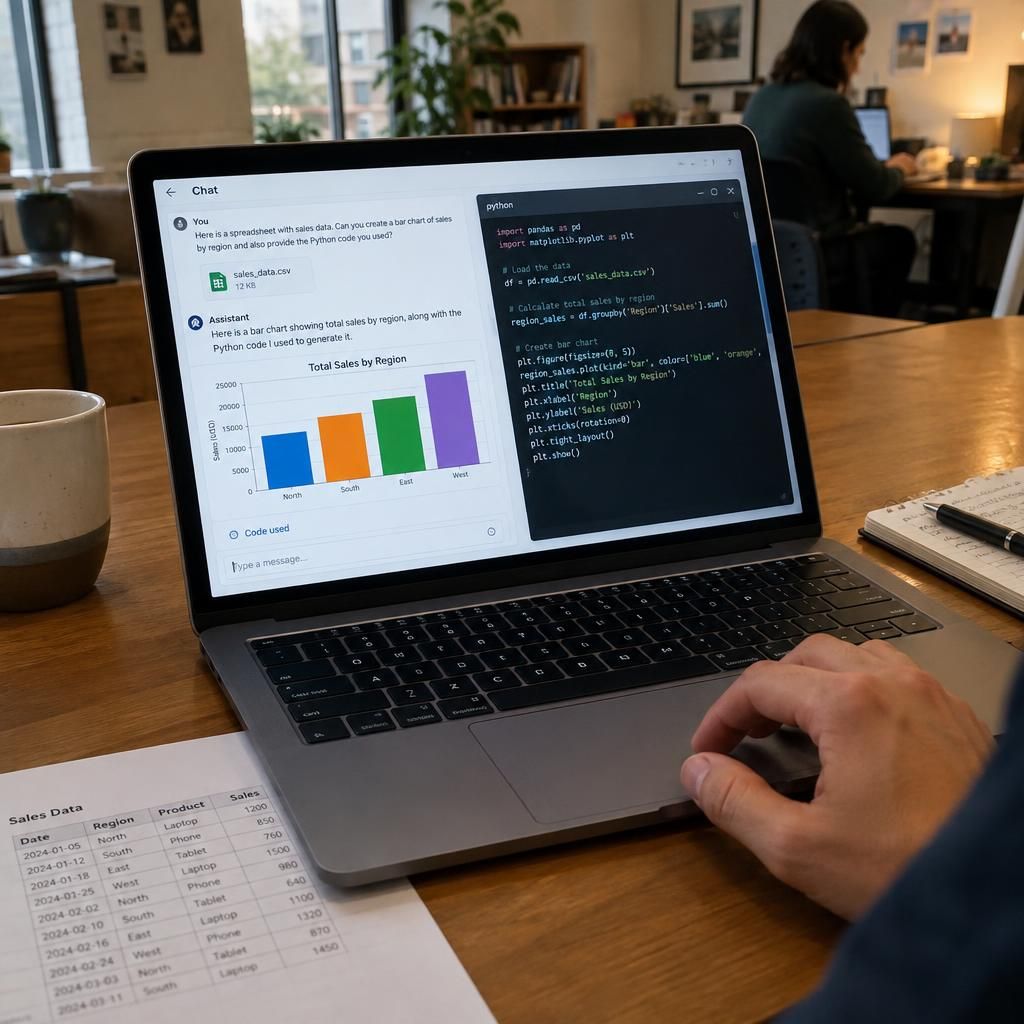
Според помощния център на OpenAI ChatGPT приема качени файлове, включително CSV и Excel таблици, и за част от задачите сам пише и изпълнява Python код в среда тип Jupyter. OpenAI изрично предупреждава, че кодът, резултатите и допусканията трябва да се проверяват, преди да се разчита на тях. Средата за анализ не може да прави външни уеб заявки.
Anthropic наскоро обяви инструмент за изпълнение на код в своето API, който позволява на Claude да пуска Python в изолирана среда, да зарежда набори от данни, да прави визуализации и статистически анализ. Важно е да се отбележи, че обявлението се отнася конкретно за API-то, а не непременно за всяка функция в чат интерфейса на продукта.
Gemini разчита на дълбоката си връзка с екосистемата на Google. Приложението позволява качване на документи и електронни таблици, а след свързване с Google Workspace дава достъп и до файлове от Google Drive директно в чата. Google посочва, че Gemini може да създава и редактира диаграми по качени таблици, а за определени платени планове контекстният прозорец стига до 1 милион токена.
 Генерирано с AI
Кой печели в различните задачи
В собствения си тест авторът на KDnuggets Винод Чугани открива, че ChatGPT е най-удобен за бързо проучване на единичен набор от данни, защото средата му за анализ е най-зряла и позволява директна работа от суровите данни до визуализация. Според същия автор Claude дава по-структурирани обяснения при статистически въпроси и по-организиран код при сложни задачи. Gemini пасва най-добре, когато е нужна актуална информация от уеб търсене или интеграция с инструментите на Google. Важно е тези наблюдения да се четат като впечатления от еднократен авторски тест, а не като независим, възпроизводим бенчмарк.
Защо резултатите пак трябва да се проверяват
И трите инструмента могат да допуснат грешка, която звучи убедително, но не е вярна. OpenAI съветва потребителите винаги да преглеждат генерирания код, изходните резултати и допусканията му. Според KDnuggets всеки от трите асистента може да пропусне съществено статистическо условие или дори да измисли число, цитат или резултат, който не съществува. Затова проверката остава задължителна стъпка, особено когато анализът ще стои зад реално бизнес решение.
Практическият извод, до който стига авторът на теста, е, че много специалисти по данни не избират само един инструмент, а комбинират два от трите според конкретната задача: единия за бързо почистване и визуализация на файл, другия за писане на по-сложен и преизползваем код. Засега това изглежда по-разумен подход от търсенето на абсолютен победител.